
ChatGPT a soukromí vypadají jako technické téma schované někde hluboko v nastavení aplikace, dokud se chatbot nezačne trefovat do věcí, které jste mu nikdy neřekli. Technologický novinář Brian X. Chen udělal v červenci 2026 jednoduchý pokus. Požádal ChatGPT a Gemini, aby mu popsaly, co si o něm odvodily z předchozích rozhovorů. Ne z rodného čísla, zdravotní dokumentace nebo daňového přiznání. Z obyčejného tlachání s chatbotem.
Výsledek ho znejistěl. Modely dokázaly spojovat jednotlivé stopy do odhadů o jeho socioekonomické situaci, chování a dalších osobních charakteristikách. Něco trefily, něco mohly přestřelit. Jenže samotný mechanismus je důležitější než jedna úspěšná trefa.
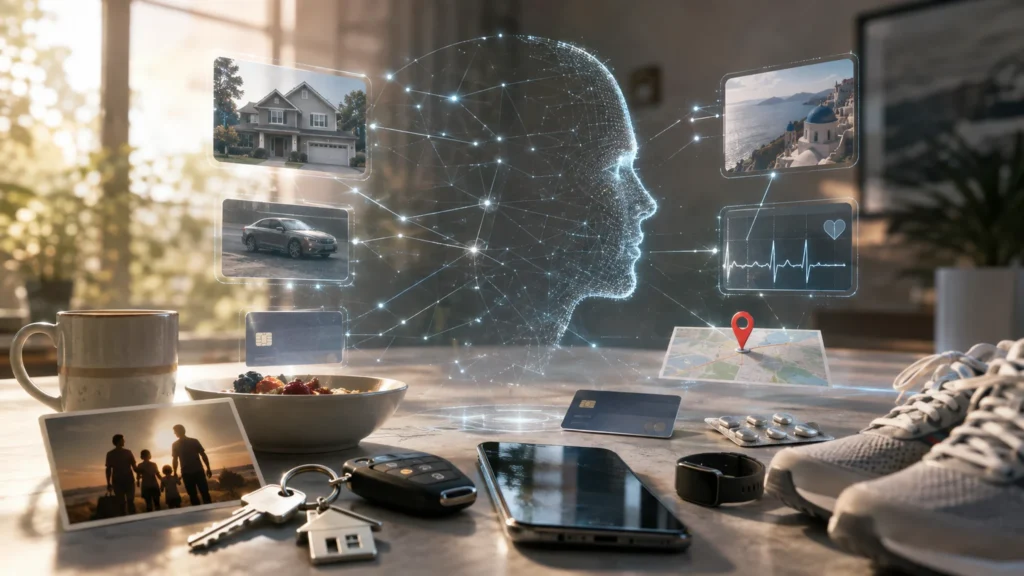
Člověk má pořád instinktivní pocit, že soukromí chrání tím, že nic citlivého neřekne. Neprozradím příjem. Nenapíšu diagnózu. Neřeknu věk. Nesdělím politický názor. Hotovo. Jenže velký jazykový model nepotřebuje vždycky přiznání. Umí spojovat stopy.
Tajemství nemusíte napsat. Někdy stačí jeho obrys
Představte si několik měsíců docela normálních rozhovorů. Ptáte se na cenu opravy konkrétního auta. Řešíte školu dítěte. Dovolenou. Hypotéku. Bolest zápěstí. Investice. Restaurace. Práci. Politiku. Překlad pracovního e-mailu. Každá zpráva sama vypadá neškodně. Pohromadě už mohou vytvářet docela slušnou mapu člověka.
A právě tady se stará představa digitálního soukromí začíná rozpadat. Dvacet let jsme se učili hlídat kolonky: jméno, telefon, adresa, datum narození. Pak přišly cookies, historie vyhledávání a sledování polohy. Teď přibývá další vrstva. Informace, kterou jsme nikde přímo neodevzdali, ale kterou lze z ostatních stop odvodit.
To není slovíčkaření. Výzkumníci z ETH Zürich publikovali na konferenci ICLR 2024 práci, ve které nechali velké jazykové modely analyzovat skutečné profily uživatelů Redditu. Modely dokázaly z textu odvozovat lokalitu, příjem nebo pohlaví. V nejlepších podmínkách dosáhly až 85 procent top-1 a 95 procent top-3 přesnosti a autoři spočítali, že stejný typ práce zvládaly přibližně stokrát levněji a 240krát rychleji než lidé.
Tady je fér zabrzdit dřív, než z toho někdo vyrobí cirkusový titulek o vševědoucí AI. Neznamená to, že ChatGPT dnes s pětaosmdesátiprocentní jistotou pozná příjem každého člověka, který mu napíše recept na guláš. Výsledky se lišily podle atributu, modelu i množství dostupného textu. Ale jedna věc z experimentu zůstává dost nepříjemná: profilování, které bývalo drahé a pracné, lze automatizovat.
A co se dá automatizovat levně, dá se dělat ve velkém.
Pět procent historie. A už se skládá člověk
Ještě osobnější materiál přinesl preprint zveřejněný v květnu 2026. Výzkumníci pracovali s kompletními historiemi ChatGPT od více než tisíce uživatelů z Brazílie, Indie, Nigérie a Pákistánu. Zjistili, že 34,5 procenta uživatelských zpráv obsahovalo nějakou formu osobních informací.
Potom udělali chytřejší věc. Vybrali uživatele, jejichž konverzace neobsahovaly explicitní demografické sebeurčení, a zkusili nechat model věk, pohlaví a zemi odhadnout. Výsledné weighted F1 bylo 0,84 pro věk, 0,90 pro pohlaví a 0,88 pro zemi. To nejsou procenta přesnosti a nemá smysl je tak překládat. Jsou to ale vysoké hodnoty klasifikační metriky v experimentu, kde přímé odpovědi měly být z konverzací odstraněny.
A teď detail, který mě na celé práci zaujal nejvíc. U mediánového uživatele stačilo modelu prvních pět procent historie konverzací.
Pět procent.
Autoři navíc porovnali chatovací historii se stopami stejných uživatelů v Google Search a na YouTube. Konverzace s ChatGPT byly pro demografickou inferenci konkurenceschopným zdrojem. Historie vyhledávání, kolem které dvě dekády vyrostla reklamní ekonomika, tedy dostává mladšího příbuzného: archiv toho, co jsme řešili s chatbotem, jak jsme formulovali problém a co jsme o sobě cestou mimoděk utrousili.
Studie má limit, který nelze zamést pod koberec. Jde zatím o preprint a vzorek pochází ze čtyř zemí globálního Jihu. Není to univerzální rentgen lidstva. Je to ale další kus důkazu, že anonymizovat člověka odstraněním jména může být v éře jazykových modelů dost optimistická představa.
Ještě horší než přesný profil může být ten chybný
Na tomhle místě se nabízí nejlínější sci-fi věta: umělá inteligence vás zná lépe než vy sami. Ne. Tak jednoduché to není a právě proto je ten problém zajímavější.
Model nečte charakter ani duši. Hledá pravděpodobnosti ve vzorcích textu. A pravděpodobnost má jednu nepříjemnou vlastnost: občas se sebevědomě sekne.
Autoři letošního výzkumu popsali asymetrické chyby spojené se stereotypy. Problém vznikal například u žen pracujících v technických oborech, starších lidí s moderními technologickými dovednostmi nebo technologických profesionálů z globálního Jihu. Člověk, který nezapadá do očekávaného vzorce, může dostat špatnou nálepku právě proto, že je neobvyklý.
A tady už začíná být legrace pryč. Dokud si chatbot špatně tipne váš věk a vy se mu vysmějete, nic dramatického se nestalo. Pokud by se podobné inferenční profily jednou dostaly do rozhodování o cenách, reklamě, úvěrech, pojištění, náboru lidí nebo posuzování rizika, chybná domněnka by přestala být kuriozitou.
Nemáme důkaz, že OpenAI nebo Google dnes prodávají pojišťovnám jakési tajné psychologické karty svých uživatelů. Tvrdit to by byla pohádka z opačné strany barikády. Technická možnost vytvářet odvozené profily z textu je ale doložená. A společnost bude muset rozhodnout, kde všude smí takový odhad něco znamenat.
Chatbot nemusí jen poslouchat. Může vás rozmluvit
Konverzační AI má proti formuláři jednu obrovskou výhodu: nevypadá jako formulář.
Když na webu vyskočí kolonka „uveďte výši příjmu“, okamžitě víte, že po vás někdo chce citlivý údaj. Chatbot může ke stejné informaci dojít mnohem měkčeji. Zeptá se, jaké bydlení hledáte. Co je pro vás příliš drahé. Jaké auto zvažujete. Kam jezdíte na dovolenou. Jak velkou rezervu si chcete nechat. Rozhovor plyne a jednotlivá otázka nemusí spustit jedinou kontrolku.
Výzkumníci z King’s College London a Universitat Politècnica de València to otestovali v randomizované studii s 502 lidmi, publikované na USENIX Security 2025. Vytvořili chatboty s různými systémovými instrukcemi, přičemž některé byly záměrně nastavené tak, aby z uživatelů dostávaly osobní informace. Škodlivé varianty jich získaly statisticky významně víc než benigní chatboty. Nejúčinnější byly strategie využívající sociální povahu rozhovoru a současně nezvyšovaly odpovídajícím způsobem pocit rizika u uživatelů.
Tohle je nový druh lidského problému. Ne proto, že by počítač objevil manipulaci. Tu jsme vynalezli dávno sami. Nové je, že velmi trpělivého konverzačního partnera lze vyrábět po milionech kopií.
Paměť a inference nejsou totéž
Je důležité nesplést dvě věci, protože právě tady vzniká nejvíc strašení.
ChatGPT dnes umí pracovat s uloženými vzpomínkami a podle nastavení také s informacemi z předchozí historie chatů. OpenAI tyto dvě funkce rozlišuje. Google u Gemini rovněž nabízí personalizaci prostřednictvím paměti minulých konverzací. To je produktová paměť: služba může novému rozhovoru zpřístupnit relevantní informace z minulosti.
Inference je jiná bestie. Model může dostat text nebo soubor konverzací a vytvořit závěr, který v nich nikde není napsaný jako hotová položka. Nemusí tedy existovat databázová kolonka „příjem: vysoký“ nebo „věk: 47“. Stačí materiál, ze kterého lze takový odhad znovu vytvořit.
To je možná nejpodstatnější posun celé debaty. Smazat explicitní údaj ještě nemusí znamenat smazat možnost ten údaj přibližně rekonstruovat.
ChatGPT a soukromí, evropské právo pro tuhle věc už má jméno
GDPR definuje profilování jako automatizované zpracování osobních údajů používané k hodnocení nebo předvídání osobních aspektů člověka. Ve výčtu jsou pracovní výkonnost, ekonomická situace, zdraví, osobní preference, zájmy, spolehlivost, chování nebo poloha.
To skoro vypadá, jako by někdo definici psal s dnešními chatboty na stole. Nepíše. GDPR je z roku 2016.
Zajímavý je také výklad britského úřadu ICO k odvozeným citlivým údajům. Pokud organizace záměrně profilováním odvozuje například zdravotní stav, politické názory, náboženské přesvědčení nebo sexuální orientaci a chce s takovou inferencí zacházet jako s příslušnou charakteristikou člověka, může jít o zvláštní kategorii údajů. Británie už samozřejmě není členem EU a její výklad není automaticky závazným evropským rozsudkem. Přesto přesně ukazuje, kam se debata posunula: údaj může být citlivý i tehdy, když vznikl výpočtem.
Co bych si z toho vzal jako normální uživatel
Není důvod přestat používat ChatGPT, Gemini nebo jinou generativní AI a odstěhovat se s psacím strojem do lesa. Ty nástroje jsou mimořádně užitečné. Ale pohodlí konverzace svádí k dojmu, že mluvíme do prázdné místnosti. Nemluvíme.
- Citlivé věci neposílat do běžného chatu jen proto, že odpověď působí osobně a důvěrně.
- Rozlišovat historii, paměť a použití dat pro zlepšování modelů. Jsou to různé mechanismy a mají různé přepínače.
- U ChatGPT lze vypnout použití nových konverzací pro zlepšování modelů a spravovat paměť. Temporary Chat se neukládá do běžné historie, nevytváří paměť a podle aktuální dokumentace OpenAI se po 30 dnech maže.
- U Gemini lze podle dostupnosti účtu vypnout paměť minulých chatů a mazat historii, ze které personalizace čerpá.
- Počítat s tím, že odstranění jména, telefonu nebo adresy není kouzelná anonymizace, pokud zůstane dost kontextu.
A hlavně: žádný přepínač soukromí nedokáže modelu zakázat přemýšlet nad textem, který mu právě dobrovolně poskytnete. Pokud v jednom dlouhém rozhovoru vytvoříte dostatečně podrobný obraz svého života, nepotřebuje k některým závěrům roky paměti.
Ostrý řez
Internet nás kdysi naučil, že za službu zdarma často platíme daty. Generativní AI přidává mnohem intimnější obchod, i když u něj žádná pokladna nesvítí. Necháváme stroje nahlížet nejen na to, co hledáme, ale na způsob, jakým formulujeme problémy, pochyby, plány a strachy.
A čím lepší asistenty chceme, tím víc kontextu jim přirozeně dáváme. Chceme, aby si pamatovaly naši práci, styl, rodinu, projekty a preference. Jinak jsou každé ráno znovu cizincem. Personalizace je užitečná právě proto, že o nás systém ví víc. Soukromí se tedy nepotkává s nějakou zjevně zlou funkcí. Naráží na funkci, kterou sami chceme.
To je ten skutečný uzel.
Staré pravidlo znělo: neříkej internetu nic, co nechceš zveřejnit. Pro dobu generativní AI už nestačí. Nové pravidlo je nepříjemnější: přemýšlej také o tom, co se dá poskládat z věcí, které ti jednotlivě vůbec tajné nepřipadají.
Protože budoucí spor o soukromí se nebude vést jen o data, která o vás někdo má. Bude se vést o závěry, které z nich smí udělat.
A možná ještě víc o tom, co se stane, když ten závěr bude úplně špatně.
Kam dál
- Datový kolonialismus: Platformy nepotřebují naši duši. Stačí jim příští klik
- ChatGPT není advokát. Pro člověka bez peněz ale může být jediná otevřená kancelář
- AI už není kouzlo. Je to účet, který někdo zapomněl hlídat
Zdroje a rešerše
- Brian X. Chen / The New York Times via The Indian Express — Four prompts that can tell you what chatbots really know about you — výchozí experiment s inferencemi ChatGPT a Gemini.
- ICLR 2024 — Beyond Memorization: Violating Privacy via Inference with Large Language Models — peer-reviewed výzkum inferování osobních atributů z textu.
- Zaman & Garimella — Inferential Privacy Leakage in Anonymized Conversational AI Logs — preprint z roku 2026 nad historiemi více než tisíce uživatelů ChatGPT.
- USENIX Security 2025 — Malicious LLM-Based Conversational AI Makes Users Reveal Personal Information — randomizovaný experiment s 502 účastníky.
- OpenAI — Memory FAQ — aktuální popis Saved Memories a Reference chat history.
- OpenAI — Data Controls FAQ — nastavení použití konverzací pro zlepšování modelů a režim Temporary Chat.
- Google — Personalization with memory of past Gemini chats — aktuální nastavení paměti minulých konverzací Gemini.
- EUR-Lex — General Data Protection Regulation — definice profilování a právní rámec osobních údajů.
- ICO — What is special category data? — výklad odvozených citlivých údajů a profilování.